الفرضية: حين تستشهد إجابة ذكاء اصطناعي بصفحة، فهي لا تسحب أطول جملة فيها ولا أكثرها أرقاماً. تسحب جملة قصيرة مبكرة وبسيطة. ما الذي ينقضها: أن تطابق الجمل المأخوذ منها متوسط الصفحة في الطول والموقع، وأن تحتوي أرقاماً بالنسبة نفسها أو أكثر.
أظهرت دراستنا عن المحركات المختلفة أي المصادر تستشهد بها محركات الذكاء الاصطناعي. هذه الدراسة تسأل سؤالاً آخر: ماذا تأخذ هذه المحركات من تلك المصادر فعلاً؟ جلبنا الصفحات المستشهد بها، وحددنا لكل استشهاد الجملة التي تعكس إجابة المحرك مضمونها أكثر من غيرها، ثم قارنا هذه الجمل ببقية الصفحة. النمط ثابت ويخالف الشائع قليلاً: إجابات الذكاء الاصطناعي تأخذ من الجمل القصيرة والمبكرة والبسيطة، لا من الجمل الطويلة المزدحمة بالإحصاءات.
عبر 377 جملة مأخوذاً منها (بنسبة مطابقة 94.5% من 399 زوجاً من الاستشهادات ومصادرها)، بلغ وسيط طول الجملة المأخوذ منها 11 كلمة مقابل 18 لوسيط الصفحة كلها، وجاءت على بعد 27.8% من أعلى الصفحة، واحتوت رقماً في 17.5% فقط من الحالات مقابل 29.2% للجملة المتوسطة في الصفحات نفسها.
الفرضية المسبقة
سجلناها قبل التحليل. توقعنا أن تكون الجمل المأخوذ منها أقصر وأبكر من متوسط الصفحة، لأن قابلية الاقتباس تميل إلى الإيجاز وموقع الصدارة. لم تكن لدينا أي توقعات بشأن الأرقام، وإن كان لا بد من توقع فقد ظننا أن الجمل التي تحمل إحصاءات ستظهر أكثر من غيرها، لأن نصائح GEO تقول “ضع البيانات في البداية”. ما ينقض الفرضية: ألا تختلف الجمل المأخوذ منها عن متوسط الصفحة في الطول والموقع.
البيانات
- صفحات المصادر: الروابط المستشهد بها في دراسة المحركات المختلفة. من أصل 453 رابطاً فريداً، جلبنا نصاً صالحاً من 316 (70%)، والباقي حجب الروبوتات أو كان خلف اشتراك مدفوع أو يعتمد على JavaScript وحده أو كان شحيح المحتوى.
- الجملة المأخوذ منها: لكل استشهاد، الجملة في المصدر التي تتقاطع كلماتها ذات المعنى مع إجابة المحرك أكثر من غيرها، فوق حد ثابت. 377 جملة مطابقة عبر 399 زوجاً لها صفحة.
- خط الأساس: كل جملة في كل صفحة مصدر (طولها، وموقعها، وهل تحتوي رقماً).
- تاريخ الجمع: 2026-06-14. المصدر: بيانات عامة أو جمعناها بأنفسنا فقط. لا بيانات لأي عميل.
المنهجية
- نجلب كل رابط مستشهد به ونستخرج النص الظاهر.
- نقسم كل صفحة إلى جمل، ونسجل لكل جملة عدد كلماتها وموقعها في الصفحة وهل تحتوي رقماً (وهذا خط أساس الصفحة).
- لكل استشهاد نأخذ إجابة المحرك، ونعطي كل جملة في المصدر درجة حسب نسبة كلماتها ذات المعنى الموجودة في الإجابة. الجملة صاحبة أعلى درجة فوق الحد هي الجملة المأخوذ منها.
- نقارن الجمل المأخوذ منها بخط أساس الصفحة في الطول والموقع ونسبة الأرقام.
هذه مطابقة لفظية (lexical) اخترناها عمداً لتعمل دون اتصال ويمكن تكرارها، وليست تضمينات دلالية (embeddings). وهي أداة خشنة: تقع أحياناً على عنوان أو سطر متكرر في كل الصفحات (إخلاء مسؤولية من نوع “استشر مقدم رعاية صحية” ظهر فعلاً ضمن المطابقات). تعامل مع الأحجام على أنها اتجاه، لا قياس دقيق.
النتائج
| المحور | الجمل المأخوذ منها | خط أساس الصفحة | القراءة |
|---|---|---|---|
| وسيط الطول | 11 كلمة | 18 كلمة | أقصر بنحو 40% |
| الموقع في الصفحة | أعلى 27.8% | موزع بالتساوي (50%) | في مقدمة الصفحة |
| تحتوي رقماً | 17.5% | 29.2% | 0.6 ضعف، أي أقل من حصتها |
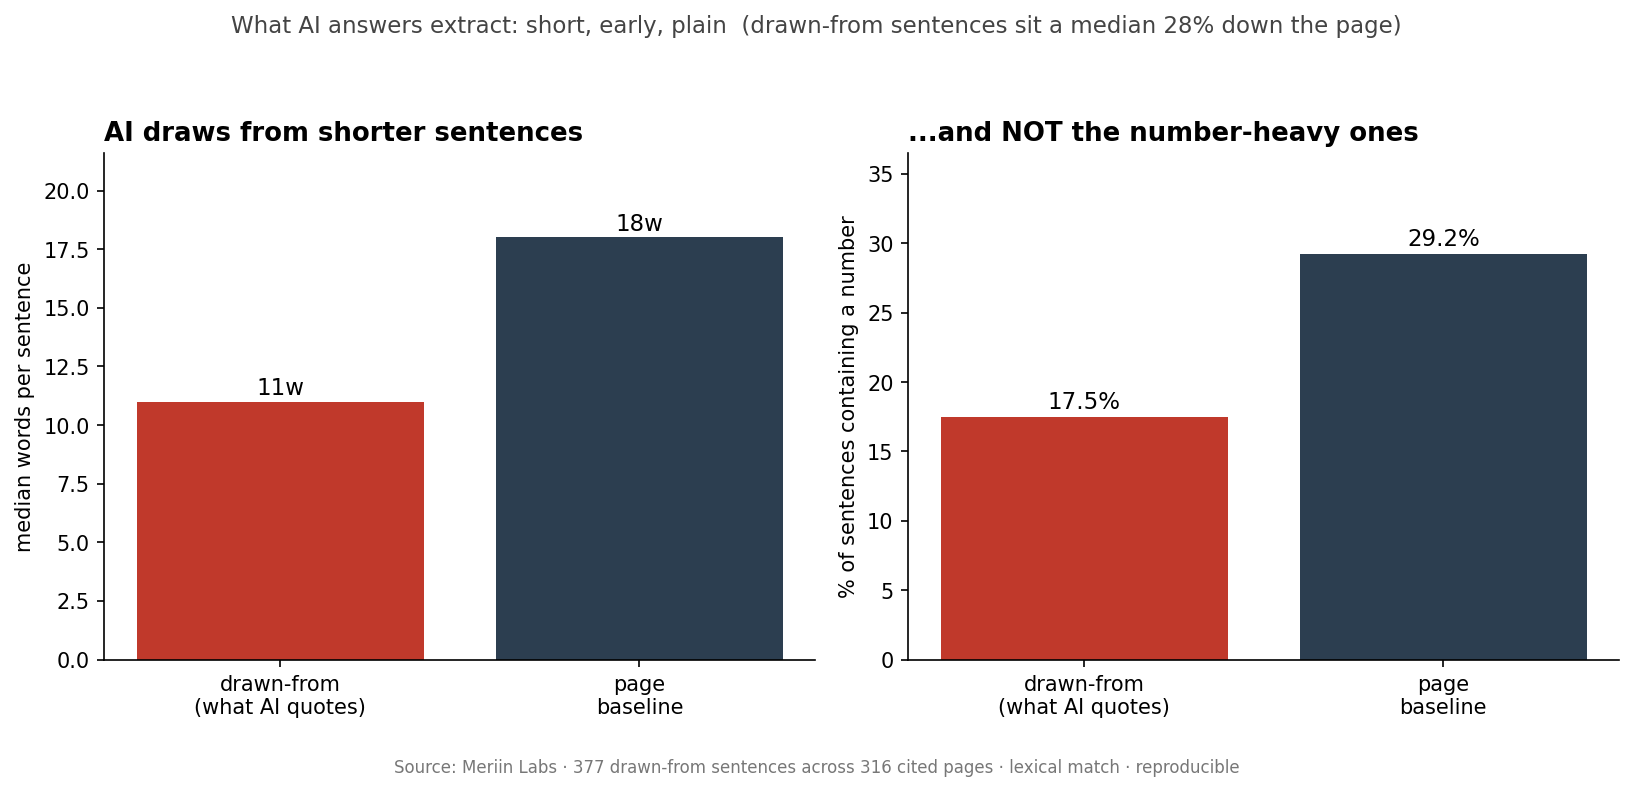
النتيجة الأولى: القصير يفوز. الجملة التي تعكسها إجابة الذكاء الاصطناعي طولها عند الوسيط 11 كلمة مقابل 18 للصفحة. قابلة للاقتباس تعني أنها تقال في نفس واحد.
النتيجة الثانية: المبكر يفوز. تتجمع الجمل المأخوذ منها في الثلث الأعلى من الصفحة (الوسيط على بعد 27.8% من الأعلى) ولا تتوزع بالتساوي. موقع الصدارة ليس تفصيلاً جمالياً في تحسين محركات البحث، بل هو المكان الذي يحدث فيه الاستخراج.
النتيجة الثالثة: الأرقام فاجأتنا. توقعنا أن تحظى الجمل المحملة بالإحصاءات بالأفضلية، فحدث العكس: الجملة التي تحتوي رقماً كانت فرصتها أقل لتكون الجملة المأخوذ منها (17.5% مقابل 29.2%، أي 0.6 ضعف). إجابات الذكاء الاصطناعي ترفع الجملة الشارحة الموجزة، وتعيد صياغة الإحصاءات المحيطة بها، بدل أن تنقل الجملة الرقمية المزدحمة حرفياً.
مستوى الثقة
- الأعداد (المستوى A). 377 جملة مطابقة من 399 زوجاً مجلوباً، محسوبة بسكربت.
- الاتجاه (المستوى B). أقصر وأبكر وأقل أرقاماً: نتائج متسقة تصمد أمام الضجيج الواضح. نتيجة الأرقام تحديداً ثابتة في اتجاهها حتى لو تغير حجمها.
- الأحجام (المستوى C). التقاطع اللفظي أداة غير حادة. يلتقط بعض العناوين والنصوص المتكررة، و”الموقع في الصفحة” محسوب على ترتيب النص المستخرج (الذي يشمل قوائم التنقل)، فستتحرك الأرقام الدقيقة مع منهجية أنظف.
حدود الدراسة
- لفظية لا دلالية. يحدد التقاطع في الكلمات ذات المعنى الجملة المأخوذ منها، لا التضمينات. تمريرة بالتضمينات (النسخة الثانية المخطط لها) ستدقق في الجملة المطابقة فعلاً وتستبعد النصوص المتكررة.
- انحياز الجلب. جلبنا 70% من الصفحات. الصفحات التي تحجب الروبوتات أو تعتمد بكثافة على JavaScript غائبة، وقد تختلف اختلافاً منهجياً.
- الموقع فيه ضجيج. ترتيب النص المستخرج يشمل القوائم والتذييلات، فعبارة “على بعد 27.8% من أعلى الصفحة” مؤشر تقريبي على أن الجملة مبكرة، لا إحداثي دقيق داخل المقال.
- لقطة واحدة واستشهادات على مستوى المصدر. المحركات تستشهد بمصادر لا بمقاطع محددة، فالجملة المأخوذ منها مستنتجة وليست معلنة.
مقارنة بالأعمال السابقة
تقول إرشادات GEO ثلاثة أشياء: ابدأ بالإجابة، واجعل جملك قصيرة، وضع إحصاءاتك في البداية. هذه البيانات تدعم الأولى والثانية بالدليل (القصير والمبكر هو فعلاً ما يستخرج)، وتعقد الثالثة: الجمل التي يستخرجها الذكاء الاصطناعي فعلاً أقل احتواءً للأرقام من المتوسط. التعديل العملي: اكتب جملة افتتاحية محكمة وبسيطة تقول الفكرة في 11 كلمة تقريباً، ودع الأرقام تدعمها في السطور التالية، بدل حشرها في الجملة التي تريد أكثر من غيرها أن تقتبس.
أعد التجربة بنفسك
في data/cited-sentences/:
fetch.py: يجلب الصفحات المستشهد بها ويستخرج النص.analyze.py: يحدد الجملة المأخوذ منها لكل استشهاد ويحسب المقارنة.cited_sentences.csv: كل جملة مأخوذ منها مع طولها وموقعها وعلامة احتوائها على رقم.FIGURES-LEDGER.csv: كل رقم ورد في هذا المقال.
شغل python3 fetch.py ثم python3 analyze.py (يقرأ مجموعة بيانات S4، فشغل جمعها أولاً).
الرقم
عبر 377 جملة أخذت منها ChatGPT وGemini وPerplexity إجاباتها، بلغ الوسيط 11 كلمة مقابل 18 للصفحة، وجاءت الجمل في أعلى 28% من الصفحة، واحتوت رقماً في 17.5% فقط من الحالات مقابل 29.2% للجملة المتوسطة. الذكاء الاصطناعي يستخرج السطر القصير المبكر البسيط، لا الإحصاء المزدحم.
سجل التغييرات والصلاحية
- صالحة حتى 2026-06-14. تعكس مجموعة بيانات المحركات المختلفة والصفحات التي أمكن الوصول إليها في ذلك التاريخ.
- النسخة الثانية ستستبدل المطابقة اللفظية بالتضمينات وتستبعد العناوين والنصوص المتكررة. نتوقع أن يصمد الاتجاه وأن تصبح الأحجام أدق.
- النسخة 1.0، 14 يونيو 2026: أول نشر باسم فريق مختبر ميريين. 316 صفحة مجلوبة، و377 جملة مطابقة، وسجل أرقام مكتمل.
تريد أن نصيغ الجملة الافتتاحية في صفحاتك المهمة لتكون قابلة للاقتباس؟ احجز تشخيص النمو المجاني
ذات صلة: محركات الذكاء الاصطناعي نادراً ما تتفق على المصادر · هل يستطيع نموذج لغوي الحكم على قابلية جملة للاستشهاد؟