الفرضية: اطلب من نموذج لغوي أن «يقيم قابلية هذه الجملة للاقتباس من 0 إلى 100» وستجد أن درجاته بالكاد تتبع معايير تقييم حقيقية. ضع المعايير نفسها داخل التعليمات وسيتفق النموذج ذاته مع المعايير في أغلب الحالات، مقابل نحو 44 رمزاً (token) إضافياً. ما الذي يثبت خطأها: تشغيل تتبع فيه التعليمات العامة المعايير بالقدر نفسه تقريباً الذي تتبعها به التعليمات المبنية على المعايير (ارتباط رتبي وتوافق متقاربان).
الفرق في كل مكان تستخدم النماذج اللغوية حكاماً: قيم هذه الصفحة وفق E-E-A-T، صنف هذه الإجابة، امنح هذه الجملة درجة «قابلية الاقتباس في الذكاء الاصطناعي». الافتراض الصامت أن النموذج القوي يعرف مسبقاً شكل الجودة، فتكفيه تعليمة قصيرة. اختبرنا هذا الافتراض على مهمة ضيقة يمكن قياسها، ولم يصمد.
بنينا معايير تقييم حتمية لقابلية الاقتباس (هي الحقيقة المرجعية)، ثم طلبنا من gpt-4o-mini تقييم الجمل نفسها بطريقتين: تعليمات عامة تطلب درجة من 0 إلى 100 فقط، وتعليمات مبنية على المعايير تذكر المعايير صراحة. على 46 جملة، سجل الحكم بالتعليمات العامة ارتباطاً رتبياً (Spearman) قدره 0.25 مع المعايير، واتفق معها في قرار «قابلة للاقتباس أو لا» في 52% من الحالات، أي أفضل قليلاً من رمي عملة. أما الحكم بالتعليمات المبنية على المعايير فوصل إلى ارتباط 0.81 وتوافق 74%. والتكلفة الوحيدة نحو 44 رمزاً إضافياً في التعليمات.
الفرضية
سجلناها مسبقاً قبل التشغيل. توقعنا أن ترتبط التعليمات العامة دون أمثلة (zero-shot) ارتباطاً ضعيفاً بالمعايير الصريحة، لأن النموذج لا يملك تعريفاً مشتركاً لـ«قابلية الاقتباس» يستند إليه، وأن كتابة المعايير صراحة سترفع التوافق كثيراً بتكلفة رمزية صغيرة. ما ينقضها: أن تطابق التعليمات العامة المعايير بقدر التعليمات المبنية عليها تقريباً.
البيانات
- عناصر الاختبار: 46 جملة إنجليزية محايدة لا تخص أي علامة، تتدرج من جمل عالية القابلية للاقتباس (موجزة، تحمل حقيقة ورقماً وكياناً مسمى) إلى جمل غير قابلة للاقتباس (متحفظة أو غامضة أو طويلة بلا توقف أو على صيغة سؤال). كتبناها لهذه الدراسة، ولا تتناول أي عميل أو قطاع.
- الحقيقة المرجعية: معايير حتمية شفافة تمنح كل جملة درجة من 0 إلى 100. تكافئ الطول المثالي، ووجود رقم أو إحصاء، وكياناً مسمى محدداً، والصيغة الخبرية، وتخصم على التحفظ والأسئلة والغموض والطول المفرط. ولأنها مكتوبة برمجياً، فالحقيقة المرجعية دقيقة وقابلة للتكرار.
- النموذج الحكم:
gpt-4o-mini، دون بحث على الويب (نريد حكم النموذج نفسه، لا نتيجة بحث)، عبر DataForSEO LLM Responses API. - تاريخ الجمع: 2026-06-14. إجمالي تكلفة الواجهة البرمجية: $0.057.
- المصدر: بيانات عامة أو جمعناها بأنفسنا فقط. الجمل والمعايير من إعداد ميريين. لا توجد أي بيانات عملاء في الدراسة أو البيانات أو الملحق.
المنهجية
- تقييم الحقيقة المرجعية. مررنا كل جملة على المعايير الحتمية.
- التعليمات العامة. سألنا النموذج: “On a 0-100 scale, how likely is an AI search engine to quote this exact sentence? Reply with only the number.”
- التعليمات المبنية على المعايير. السؤال نفسه مع إدراج المعايير في التعليمات: كافئ الحقيقة المكتفية بذاتها، والرقم، والكيان المسمى، والطول بين 8 و28 كلمة، والصيغة الخبرية، واخصم على التحفظ والأسئلة والغموض والطول المفرط.
- المقارنة. لكل نوع من التعليمات قسنا متوسط الخطأ المطلق (MAE) مقابل المعايير، والارتباط الرتبي (Spearman)، والتوافق الثنائي في قرار «قابلة للاقتباس» (درجة ≥ 60)، ومتوسط رموز التعليمات.
نقصد بـ«المبنية على المعايير» هنا أننا كتبنا المعايير في التعليمات يدوياً. والفكرة الأوسع بنيوية: أداة تحسين التعليمات الآلية ستبحث عن تعليمات تؤدي المهمة نفسها. في الحالتين، الرافعة هي ترميز المعايير، لا اختيار نموذج أذكى.
النتائج
| التعليمات | Spearman | التوافق الثنائي | MAE | متوسط رموز التعليمات |
|---|---|---|---|---|
| عامة | 0.25 | 52% | 31.6 | 51.1 |
| مبنية على المعايير | 0.81 | 74% | 24.6 | 95.5 |
كتابة المعايير في التعليمات ضاعفت الارتباط الرتبي أكثر من ثلاث مرات (من 0.25 إلى 0.81)، ورفعت التوافق الثنائي من مستوى قريب من العشوائية إلى 74%، وخفضت متوسط الخطأ المطلق 7.1 نقطة. والثمن 44.4 رمزاً إضافياً في كل استدعاء.
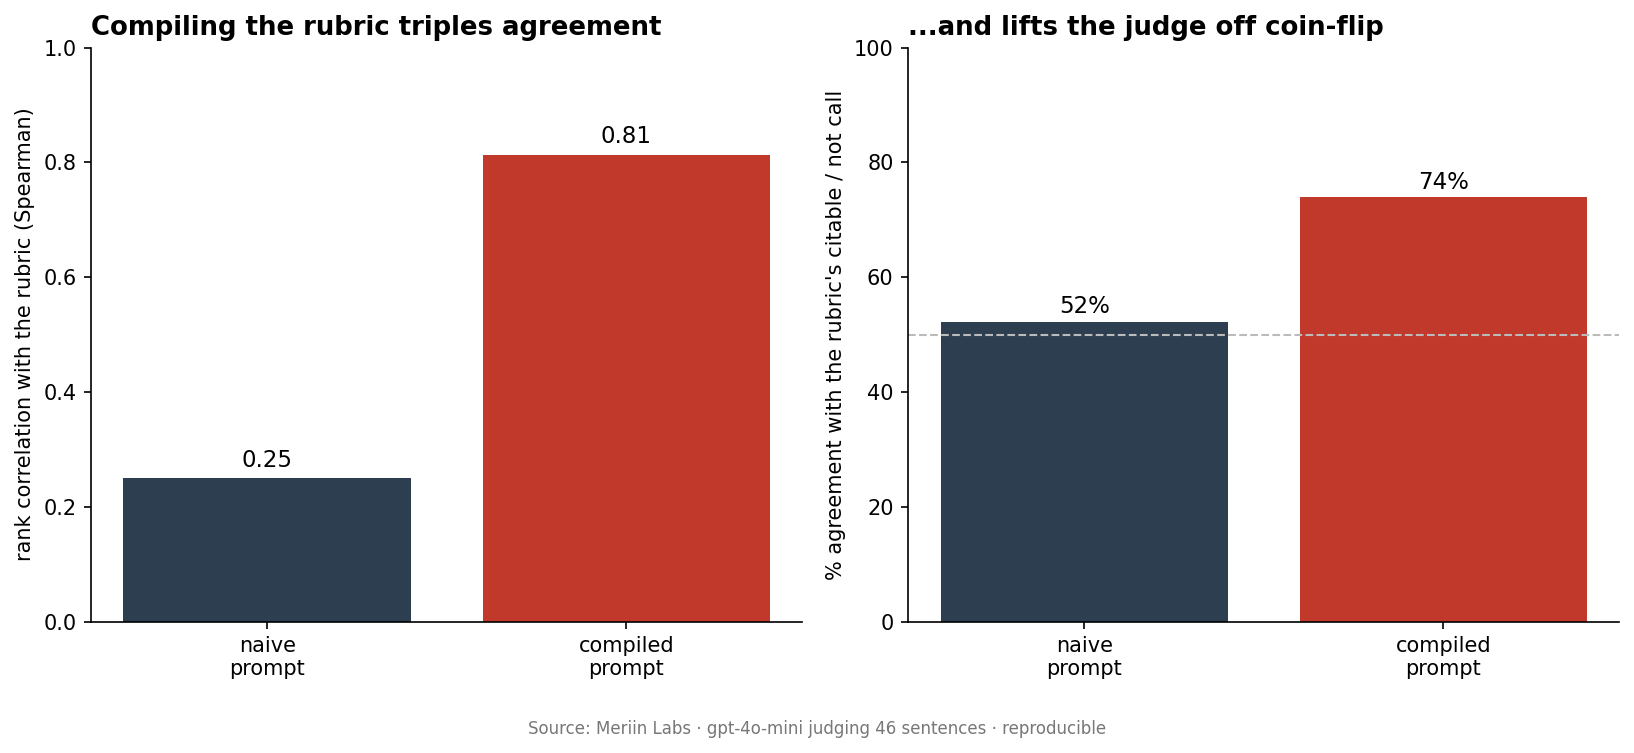
نمط الإخفاق هو الجزء الأهم. في جملة حقيقية واضحة مثل “The Great Barrier Reef stretches over 2,300 kilometres…” (درجتها في المعايير 90)، منحها الحكم بالتعليمات العامة 10، ومنحها الحكم بالتعليمات المبنية على المعايير 95. النموذج لم يكن ينقصه علم. كان ينقصه تعريف، ولما حصل عليه وصل النموذج نفسه إلى الإجابة الصحيحة.
درجة الثقة
- المقاييس (المستوى A). 46 جملة، تشغيل كامل، محسوب برمجياً. معدلات الارتباط والتوافق دقيقة لهذه البيانات وهذا النموذج.
- قابلية التعميم (المستوى B). «الحقيقة المرجعية» هنا معايير تقديرية، لا تقييم بشري لقابلية الاقتباس. فهذه الدراسة تبرهن بوضوح أن تصميم التعليمات يحدد مدى تطابق حكم النموذج مع معايير مستهدفة، ولا تثبت أن المعايير تساوي قابلية الاقتباس الفعلية. والنتيجة المنهجية تصمد أياً كانت صحة المعايير نفسها.
حدود الدراسة
- نموذج واحد ومجموعة بيانات واحدة. نموذج حكم واحد (
gpt-4o-mini) و46 جملة. قد تقلص النماذج الأكبر فجوة التعليمات العامة، وهذا اختبار أول لا الكلمة الأخيرة. أداة الاختبار تعمل مع أي نموذج. - المعايير تقديرية. تقيس التوافق مع تعريف صريح، لا إجماعاً بشرياً على قابلية الاقتباس. والخطوة التالية الطبيعية حقيقة مرجعية يقيمها بشر.
- على مستوى الجملة فقط. الحكم الفعلي على قابلية الاقتباس يجري على فقرات في سياقها. عزلنا متغير تصميم التعليمات عمداً.
مقارنة بالأعمال السابقة
استخدام النموذج اللغوي حكماً (LLM-as-a-judge) صار ممارسة معتادة، والإخفاق المعروف أن الحكم ينحرف دون معايير واضحة وصريحة. هذه الدراسة تضع رقماً لهذا الانحراف في مهمة محددة قريبة من عالم تحسين محركات البحث: الحكم بالتعليمات العامة يقترب من العشوائية (توافق 52%)، والحكم بمعايير صريحة يصل إلى 74%، بتكلفة رمزية تافهة. الخلاصة العملية لكل من يقيم المحتوى أو قابلية الاقتباس أو E-E-A-T بنموذج لغوي: النموذج ليس عنق الزجاجة، المعايير المكتوبة في التعليمات هي العنق. اصرف جهدك في كتابة المعايير، لا في البحث عن نموذج أكبر.
أعد التجربة بنفسك
كل شيء موجود في data/citability-judge-benchmark/:
benchmark.py: المعايير، ونوعا التعليمات، واستدعاء النموذج، والمقاييس.sentences.json: جمل الاختبار الست والأربعون.results.csv: درجة المعايير لكل جملة ودرجة كل حكم.FIGURES-LEDGER.csv: كل رقم ورد في هذا المقال.
شغل python3 benchmark.py (يحتاج بيانات اعتماد DataForSEO في ملف .env محلي). غير النموذج بالخيار --model، أو عدل المعايير والتعليمات وأعد التشغيل، وستتحدث الأرقام تلقائياً.
الرقم
حين طلبنا من
gpt-4o-miniالحكم على قابلية الجمل للاقتباس دون معايير، اتفق مع المعايير الصريحة في 52% فقط من الحالات (Spearman 0.25). كتابة المعايير في التعليمات رفعت التوافق إلى 74% والارتباط الرتبي إلى 0.81، مقابل نحو 44 رمزاً إضافياً. في عمل النموذج الحكم، المعايير المكتوبة في التعليمات أهم من النموذج نفسه.
سجل التحديثات والصلاحية
- صالحة حتى 2026-06-14. تعكس سلوك
gpt-4o-miniفي ذلك التاريخ عبر DataForSEO LLM Responses API. - سنعيد التشغيل كلما تغيرت النماذج، أو مقابل حقيقة مرجعية يقيمها بشر.
- الإصدار 1.0، 14 يونيو 2026: النشر الأول باسم فريق مختبر ميريين. تشغيل كامل (46 جملة)، وسجل الأرقام مكتوب. لاحقاً واختيارياً: اختبار عدة نماذج، ومعايير يقيمها بشر، ورسم بياني داخل النص.
تبني نموذجاً حكماً لتقييم المحتوى أو قابلية الاقتباس؟ ← احجز تشخيص النمو المجاني
ذات صلة: كل تجارب مختبر ميريين · ما الذي تفعله إشارات Google المسربة فعلاً