الفرضية: من بين خصائص Google المسربة التي يعمل عليها خبراء تحسين محركات البحث فعلاً، روافع الترتيب الإيجابية أقلية صغيرة. معظم الإشارات المسربة موجودة لـالخفض، أو فرز الجودة، أو التخزين والاختيار، أو الفهم، لا للرفع. ما الذي يثبت خطأها: تصنيف وظيفي للمجموعة نفسها تكون فيه إشارات «الرفع» الفئة الأكبر، أو تنخفض فيه حصة الإشارات غير الرافعة عن نحو 60%.
حين تسربت وثائق Google Content Warehouse في مايو 2024، قرأها قطاع تحسين محركات البحث كقائمة عوامل ترتيب، أشياء تضيفها فيرتفع موقعك. هذه القراءة تفترض ضمناً أن معظم الإشارات روافع تسحبها لتفوز. اختبرنا هذا الافتراض بتصنيف ما تفعله كل إشارة مسربة فعلاً.
الإجابة: من أصل 119 خاصية مسربة مختلفة تظهر كبنود عملية في تدقيق تقني كامل، 16 فقط (13.4%) روافع ترتيب إيجابية. أما الـ103 الباقية (86.6%) فموجودة لتخفض الترتيب، أو تفرز الجودة، أو تدير التخزين والاختيار، أو تقرأ التفاعل، أو تفهم المحتوى، أو تقيس تجربة الصفحة، أو تمنح ميزات في صفحة النتائج. نموذج «عوامل الترتيب» خاطئ. التسريب في أغلبه آلة لـعدم الخسارة، لا للفوز.
الفرضية
سجلناها مسبقاً قبل التصنيف. توقعنا أن تهيمن على التسريب إشارات الخفض والبنية التحتية لا الروافع الإيجابية، لأن توجيهات Google العلنية ركزت عقداً كاملاً على تجنب المشاكل (المحتوى الضعيف، والرسائل المزعجة، وسوء تجربة المستخدم) أكثر من إضافة حيل للترتيب. ما ينقضها: أن تكون إشارات «الرفع» أكبر فئة منفردة، أو أن تقل الإشارات غير الرافعة عن نحو 60% من الإجمالي.
البيانات
- المصدر: مجموعة بنود
technical-seo-auditالخاصة بميريين (generate_audit_sheet.py)، وهي تدقيق تقني من 402 بند في 21 فئة، ويربط عمودgoogle_signalفيه كل بند بالخاصية أو الخصائص المسربة من Content Warehouse التي تقابله. - وحدة التحليل: الخاصية المسربة المختلفة (مثل
navDemotionوsiteAuthorityوgoldmineBodyFactor). تظهر 119 خاصية مختلفة في 240 من أصل 402 بند، والبنود الـ162 الباقية لا تشير إلى خاصية مسربة محددة (تغطي ممارسات جيدة لا يسميها التسريب). - تاريخ الجمع: 2026-06-14 · النطاق: عالمي / إنجليزي · حالة المحرك: المعرفة العلنية بعد تسريب 2024.
- تحديد مهم للنطاق: هذا ليس التسريب كاملاً. كشف التسريب الخام آلاف الخصائص في أنظمة Google للوثائق والترتيب، وهذه الدراسة تصنف الـ119 التي تظهر كإشارات تدقيق عملية، أي الجزء الذي يفحصه خبير تحسين محركات البحث ويعمل عليه فعلاً. النتيجة تخص هذا الجزء العملي، ونذكر ذلك كلما كان مهماً.
- المصدر: بيانات عامة أو جمعناها بأنفسنا فقط. أسماء الخصائص من تسريب واجهة Google البرمجية العلني في 2024، ومجموعة بنود التدقيق من إعداد ميريين. لا توجد أي بيانات عملاء في البيانات أو السجل أو الملحق.
المنهجية
- الاستخراج. حللنا
generate_audit_sheet.pyبوحدةastفي Python (دون تشغيل أي كود)، وسحبنا كل صف تدقيق من 8 حقول مع خانةgoogle_signalالخاصة به. ←data/.../raw/audit_rows.csv. - التجزئة. قسمنا كل خانة
google_signalإلى رموز خصائص منفردة، واستبعدنا الخانات الفارغة المعلمة برمز بديل والعبارات الإنجليزية العادية التي ليست خصائص. - التصنيف. منحنا كل خاصية مختلفة واحدة من 8 وظائف وفق قواعد صريحة قابلة للتدقيق (خريطة منتقاة للخصائص الموثقة جيداً، ثم قواعد احتياطية بالكلمات المفتاحية):
- promotion (رفع): رافعة ترتيب إيجابية (PageRank، وعوامل Goldmine للعنوان والنص، و
onsiteProminence، ورفع المراجعات) - demotion (خفض): كبح أو عقوبة أو مرشح أمان (
*Demotion، والرسائل المزعجة، والإباحية، والاحتيال، والنوافذ المنبثقة، والنص العشوائي) - quality_gate (فرز الجودة): تقييم شامل للجودة أو السلطة أو E-E-A-T (
siteAuthority، وNSR، وYMYL، وcontentEffort، والأصالة، والتأليف) - storage_selection (التخزين والاختيار): الفهرسة أو التخزين أو الزحف أو إزالة التكرار أو الأخطاء أو المستويات (
scaledSelectionTierRank، وindexinginfo، وshingleInfo، وContentChecksum96) - engagement (التفاعل): النقرات والسلوك (
GoodClicks، وBadClicks، وlastLongestClicks، وchromeInTotal) - understanding (الفهم): فهم الكيانات أو التضمينات أو الدلالة أو التواريخ أو النصوص في الصور (
webrefEntities، وsite2vecEmbeddingEncoded) - technical (تقني): مقاييس تجربة الصفحة (مؤشرات أداء الويب الأساسية:
lcp/cls/inp، وTTFB، والجوال، وhttp2، وSSL) - serp_feature (ميزات النتائج): أهلية الظهور في الميزات (
richsnippet، والتسوق، وتوليد المقتطفات، وترخيص الصور)
- promotion (رفع): رافعة ترتيب إيجابية (PageRank، وعوامل Goldmine للعنوان والنص، و
- تصنيف درجة اليقين. يحمل كل تصنيف درجة ثقة في الوظيفة: مؤكد (الوظيفة تعريفية أو موثقة في التسريب العلني أو تحليل وزارة العدل الأمريكية) أو مستنتج (مستنبط من الاسم وسياق التدقيق). 74 من 119 مؤكدة، و45 مستنتجة.
القواعد الكاملة والصفوف الخام وتصنيف كل إشارة وسجل الأرقام موجودة في data/google-leak-signals-classified/، ويمكن إعادة تشغيلها بأمر واحد.
النتائج
توزيع الوظائف حسب الإشارة المختلفة:
| الوظيفة | إشارات مختلفة | الحصة | أمثلة على الخصائص |
|---|---|---|---|
| demotion (خفض) | 29 | 24.4% | pandaDemotion، navDemotion، serpDemotion، clutterScore، vlq، anchorMismatchDemotion، spambrainData، GibberishScore |
| quality_gate (فرز الجودة) | 26 | 21.8% | siteAuthority، CompressedQualitySignals، contentEffort، predictedDefaultNsr، ymylHealthScore، OriginalContentScore |
| promotion (رفع) | 16 | 13.4% | goldmineBodyFactor، goldmineHeaderIsH1، onsiteProminence، homepagePagerankNs، PageRankPerDocData، numOffdomainAnchors |
| storage_selection (التخزين والاختيار) | 14 | 11.8% | indexinginfo، scaledSelectionTierRank، ContentChecksum96، forwardingdup، robotsinfolist، isErrorPage |
| understanding (الفهم) | 14 | 11.8% | webrefEntities، site2vecEmbeddingEncoded، EntityAnnotations، lastSignificantUpdate، bylineDate |
| technical (تقني) | 10 | 8.4% | mobileCwv، lcp، cls، inp، time-to-first-byte-per-doc، isSmartphoneOptimized |
| engagement (التفاعل) | 6 | 5.0% | GoodClicks، BadClicks، lastLongestClicks، chromeInTotal |
| serp_feature (ميزات النتائج) | 4 | 3.4% | richsnippet، shoppingProductInformation، SnippetBrain، imageLicenseInfo |
النسب حصة من 119 إشارة مختلفة. لم تبق أي إشارة دون تصنيف.
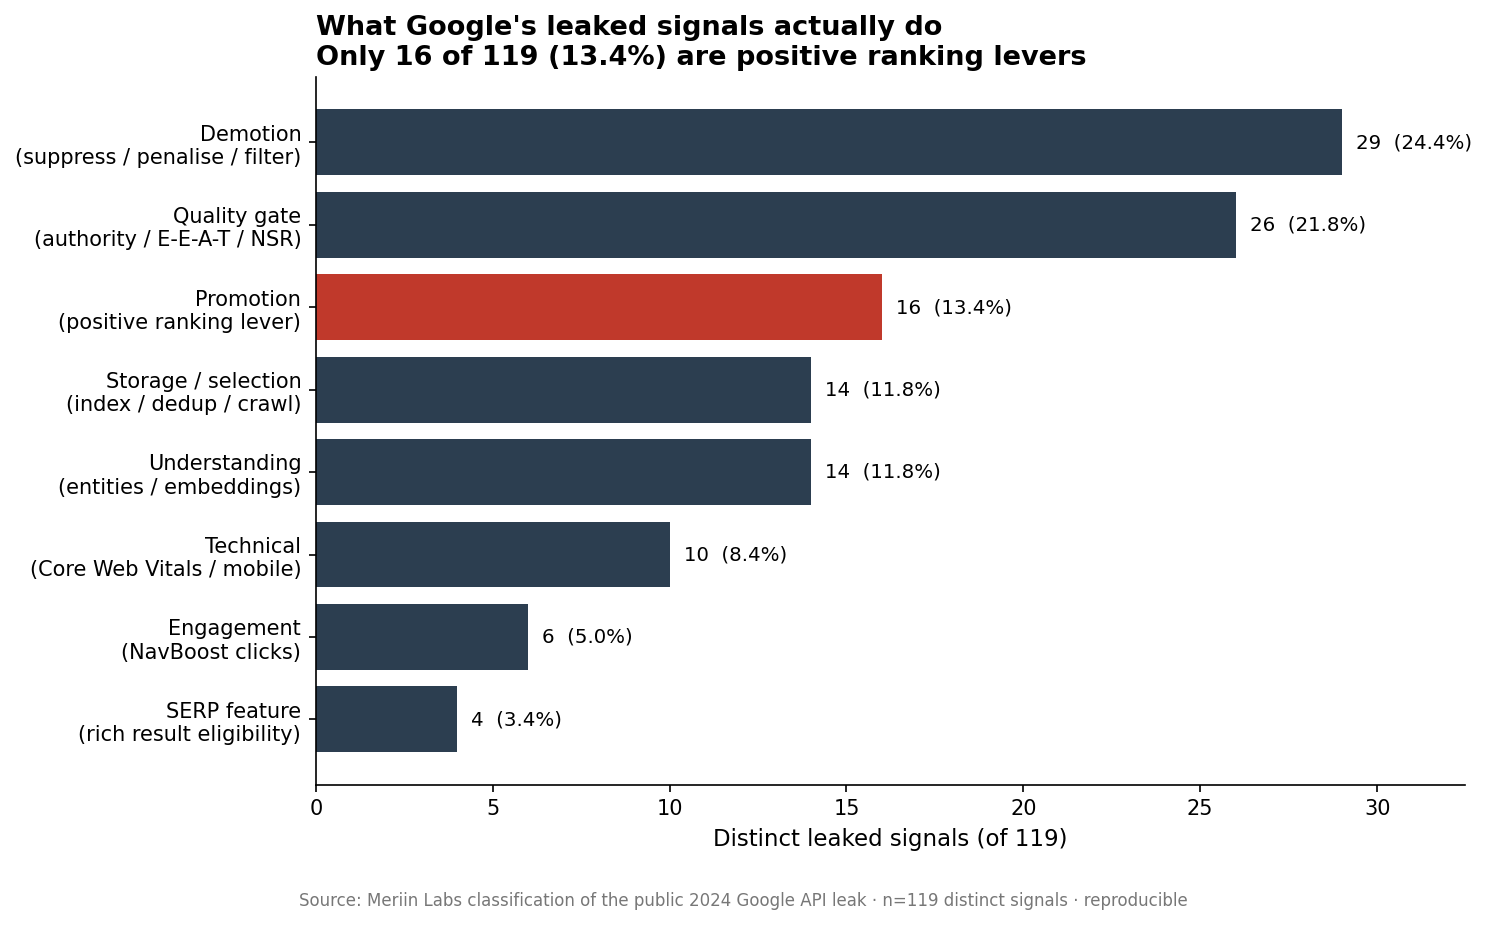
النتيجة الرئيسية:
| التجميع | الإشارات | الحصة |
|---|---|---|
| روافع ترتيب إيجابية (رفع) | 16 | 13.4% |
| كل ما عداها (خفض / فرز / تخزين / قراءة / فهم / قياس / ميزات) | 103 | 86.6% |
حسب تكرار الظهور في بنود التدقيق (كم مرة تلمس كل وظيفة البنود الـ402، لأن الإشارة الواحدة قد تتكرر)، يبقى الشكل نفسه ويزداد وضوحاً في جانب البنية التحتية: يظهر الخفض في 76 بنداً، والتخزين والاختيار في 70، وفرز الجودة في 49، والرفع في 36 فقط.
درجة الثقة
- الأعداد (المستوى A). 402 بند، و21 فئة، و119 إشارة مختلفة، وتقسيم 240/162 كلها حصر كامل للمجموعة محسوب برمجياً، لا عينة. وهي دقيقة وقابلة للتكرار.
- توزيع الوظائف (المستوى B). التصنيف الثماني من وضع ميريين. 74 من 119 تصنيفاً مؤكدة (الوظيفة تعريفية أو موثقة في التسريب أو لدى وزارة العدل، مثل أي خاصية اسمها حرفياً
*Demotion)، و45 مستنتجة. والنتيجة الرئيسية (نحو 13% مقابل نحو 87%) تصمد أمام إعادة التصنيف: حتى لو كانت كل التصنيفات المستنتجة خاطئة وانحازت كلها لصالح «الرفع»، فلا يمكن واقعياً أن يتجاوز الرفع ثلث المجموعة. - دون ترجيح بالأثر (معلن لا مخفي). كل إشارة مختلفة تحسب مرة واحدة. بوابة واحدة مثل
siteAuthorityقد تؤثر أكثر بكثير من عشر خصائص غامضة. تقيس هذه الدراسة عدد الإشارات التي تؤدي كل وظيفة، لا مقدار تأثير كل إشارة في الترتيب.
حدود الدراسة
- الجزء العملي لا التسريب كله. الخصائص الـ119 هي المجموعة المرتبطة بالتدقيق، لا كل خصائص Google. الادعاء محصور في «الإشارات التي يعمل عليها خبراء SEO»، لا «Google كله».
- تصنيف الوظائف تفسيري. حين لا يعرف التسريب سلوك الخاصية، استنتجناه من اسمها وسياقها في التدقيق وصنفناه مستنتجاً. ومطابقة كل خاصية بتعريفها في التسريب الخام هي خطوة التحصين في الإصدار الثاني.
- لا سببية. هذا تصنيف لـالغرض من الإشارات، لا دليل على أن أياً منها يغير الترتيب بمقدار محدد.
- مرتبط بالمجموعة المدروسة. الأعداد تعكس الخصائص التي اختارت ميريين إظهارها كبنود تدقيق. تدقيق مختلف سيشير إلى جزء مختلف (متداخل)، والسكربت يتيح إعادة تصنيف أي مجموعة كهذه.
مقارنة بالأعمال السابقة
كشف التسريب راند فيشكن (SparkToro)، وقدم مايك كينغ (iPullRank) قراءته التقنية المرجعية، وكلاهما في مايو 2024، وتأكدت إشارات NavBoost والنقرات تحت القسم في قضية مكافحة الاحتكار US v. Google. معظم تلك التغطية، ومئات المقالات التي تلتها، عددت خصائص مثيرة (siteAuthority موجودة! بيانات Chrome! إشارات المؤلف!) وقرأتها كقائمة تحقق لعوامل الترتيب.
لا تعترض هذه الدراسة على أي خاصية منفردة، لكنها تضيف المقام الغائب. حين تصنف المجموعة العملية كلها حسب الوظيفة، تنقلب قراءة «قائمة عوامل الترتيب»: الإشارة المسربة الأكثر شيوعاً خفض (24.4%) أو فرز جودة (21.8%)، لا رافعة (13.4%). وهذا يعيد توجيه العمل اليومي في تحسين محركات البحث من «ماذا أضيف لأرتفع» إلى «ما الذي يعاقبني أو يفرزني أو يستبعدني». ولهذا تبدأ خدمات تحسين محركات البحث التقنية لدينا بفحص التعرض للخفض والفهرسة قبل لمس الروافع الإيجابية، وهذا أقرب إلى ما تقوله توجيهات Google نفسها منذ سنوات. ويوضح أيضاً ما يترتب على ذلك في GEO والبحث بالذكاء الاصطناعي: إشارات الفهم (الكيانات والتضمينات) صارت حصة أكبر من الآلة مقارنة بالروافع الإيجابية.
لا نعيد ذكر الأرقام الرئيسية لأي كاتب سابق عمداً. هذا تصنيف مستقل بقواعد منشورة خاصة به.
أعد التجربة بنفسك
كل ما تحتاجه لتكرار التصنيف أو الطعن فيه موجود في data/google-leak-signals-classified/:
extract_classify.py: أداة الاستخراج والتصنيف كاملة (الخريطة المنتقاة وقواعد الكلمات المفتاحية).raw/audit_rows.csv: البنود الـ402 المستخرجة كلها (دليل غير قابل للتعديل).signals_classified.csv: كل إشارة مختلفة مع وظيفتها ودرجة الثقة والقاعدة وعدد مرات ظهورها.FIGURES-LEDGER.csv: كل رقم في هذا المقال مربوط بمصدره.
شغل python3 extract_classify.py. لا توافق على تصنيف ما؟ عدل خريطة CURATED وأعد التشغيل، وستتحدث الأرقام تلقائياً. وهذا هو المقصود: التصنيف حجة تستطيع تدقيقها سطراً سطراً، لا رقم مطلوب منك أن تثق به.
الرقم
من أصل 119 إشارة مسربة مختلفة من Google تظهر كبنود تدقيق عملية، 16 فقط (13.4%) روافع ترتيب إيجابية. والـ103 الباقية (86.6%) موجودة لتكبح، أو تفرز الجودة، أو تخزن وتختار، أو تقرأ التفاعل، أو تفهم المحتوى، أو تقيس تجربة الصفحة، أو تمنح ميزات في صفحة النتائج. «عوامل الترتيب» إطار خاطئ لفهم التسريب.
سجل التحديثات والصلاحية
- صالحة حتى 2026-06-14. تعكس الفهم العلني بعد تسريب 2024 والنسخة الحالية من مجموعة
technical-seo-audit(402 بند). - سنعيد التشغيل إذا تغيرت المجموعة أو كلما طابقنا تعريفات التسريب الخام (ما سينقل تصنيفات مستنتجة إلى مؤكدة).
- الإصدار 1.0، 14 يونيو 2026: نشر باسم فريق مختبر ميريين. مراجعة أسلوبية كاملة، وفحص جودة من 50 بنداً (إصلاحات في وسم العنوان وطول الوصف واسم الكاتب والرسم داخل النص والروابط الداخلية)، ومطابقة سجل الأرقام وفحص خلو البيانات من معلومات العملاء نظيفان. لاحقاً واختيارياً: اسم كاتب محدد ودرجة قابلية الاقتباس الذاتي في GEO.
تريد تطبيق هذا على موقعك وإشاراتك ومدى تعرضك للخفض؟ ← احجز تشخيص النمو المجاني
ذات صلة: خدمات تحسين محركات البحث التقنية · كيف نقيس النتائج · كل تجارب مختبر ميريين