الفرضية: لا يوجد «بحث ذكاء اصطناعي» واحد تحسن موقعك له. ChatGPT وGemini وPerplexity تقتبس في الغالب مصادر مختلفة للسؤال نفسه، وبأعداد متفاوتة جداً. ما الذي يثبت خطأها: أن تظهر أغلبية كبيرة من النطاقات المقتبسة في محركين أو أكثر، أي أن المحركات تلتقي على مجموعة مصادر مشتركة.
معظم نصائح الظهور في محركات الذكاء الاصطناعي (GEO) تتحدث عن «أن يقتبسك الذكاء الاصطناعي» كأنه جهة واحدة. طرحنا 25 سؤالاً معلوماتياً متطابقاً على ChatGPT وGemini وPerplexity مع تفعيل البحث على الويب، وسجلنا كل مصدر اقتبسه كل محرك، فانهار افتراض المحرك الواحد. أنتجت المحركات الثلاثة 559 اقتباساً إلى 322 نطاقاً مختلفاً، ولم يذكر أكثر من محرك واحد سوى 28% من هذه النطاقات. و13 نطاقاً فقط ذكرتها المحركات الثلاثة كلها. في نحو ثلاثة أرباع الحالات، «الفوز» باقتباس من الذكاء الاصطناعي فوز على محرك واحد فقط.
الفرضية
سجلناها مسبقاً قبل جمع البيانات. لو كانت «اقتباسات الذكاء الاصطناعي» هدفاً واحداً، لالتقت المحركات: معظم النطاقات المقتبسة ستظهر في أكثر من محرك. توقعنا العكس، أن لكل محرك نظام استرجاع خاصاً به وأن التداخل سيكون منخفضاً. ما ينقضها: أغلبية من النطاقات المشتركة بين المحركات.
البيانات
- الأسئلة: 25 سؤالاً معلوماتياً بالإنجليزية العامة، محايدة لا تخص أي علامة، في الصحة والمال والتقنية والإرشادات العملية وأبحاث المنتجات والعلوم والسفر والطبخ والقانون والمسار المهني والبيئة. لا موضوعات تخص عملاء أو قطاعات.
- المحركات: ChatGPT (
gpt-4o-mini)، وGemini (gemini-2.5-flash)، وPerplexity (sonar)، استدعينا كلاً منها عبر DataForSEO LLM Responses API مع تفعيل البحث على الويب، فأعاد الإجابة ومعها المصادر المقتبسة والاستعلامات المتفرعة (fan-out). - وحدة القياس: النطاق المقتبس. 559 اقتباساً تحولت إلى 322 نطاقاً. يقتبس Gemini عبر روابط إعادة توجيه خاصة بالإسناد (grounding)، فتتبعنا كل رابط إلى وجهته الحقيقية لتصبح النطاقات قابلة للمقارنة.
- تاريخ الجمع: 2026-06-14. إجمالي تكلفة الواجهة البرمجية: $1.76. الأخطاء: 0 في 75 استدعاء.
- المصدر: بيانات عامة أو جمعناها بأنفسنا فقط. الأسئلة والكود من إعداد ميريين. لا توجد أي بيانات عملاء في أي جزء.
المنهجية
- الجمع. شغلنا الأسئلة الخمسة والعشرين على كل محرك، وحفظنا كل استجابة خام دون تعديل.
- الاستخراج. سحبنا من كل استجابة نص الإجابة وقائمة الاقتباسات (العنوان والرابط) والاستعلامات المتفرعة، وتتبعنا روابط Gemini إلى عناوينها الحقيقية.
- التصنيف. اختصرنا كل اقتباس إلى نطاقه، ووسمنا نوع المصدر بقاعدة تقديرية شفافة (موسوعة، منتدى أو محتوى ينشئه المستخدمون، فيديو، طبي، حكومي، تعليمي، أو تجاري لكل ما عدا ذلك).
- القياس. عدد الاقتباسات لكل إجابة في كل محرك، والنطاقات المختلفة، والتداخل بين المحركات، وتركز الاقتباسات (مؤشر هيرفندال)، وتوزيع أنواع المصادر.
النتائج
النتيجة 1: المحركات بالكاد تتداخل. من أصل 322 نطاقاً، ذكر محرك واحد فقط 232 نطاقاً (72%)، وذكر محركان 77، ولم تذكر المحركات الثلاثة سوى 13. وبصيغة أخرى، 28% فقط من النطاقات المقتبسة وصلت إلى أكثر من محرك. المجموعة المشتركة صغيرة ومتوقعة (YouTube وWikipedia وHealthline وMayo Clinic وIBM وFidelity وIndeed وChase). وكل ما سواها خاص بمحرك بعينه.
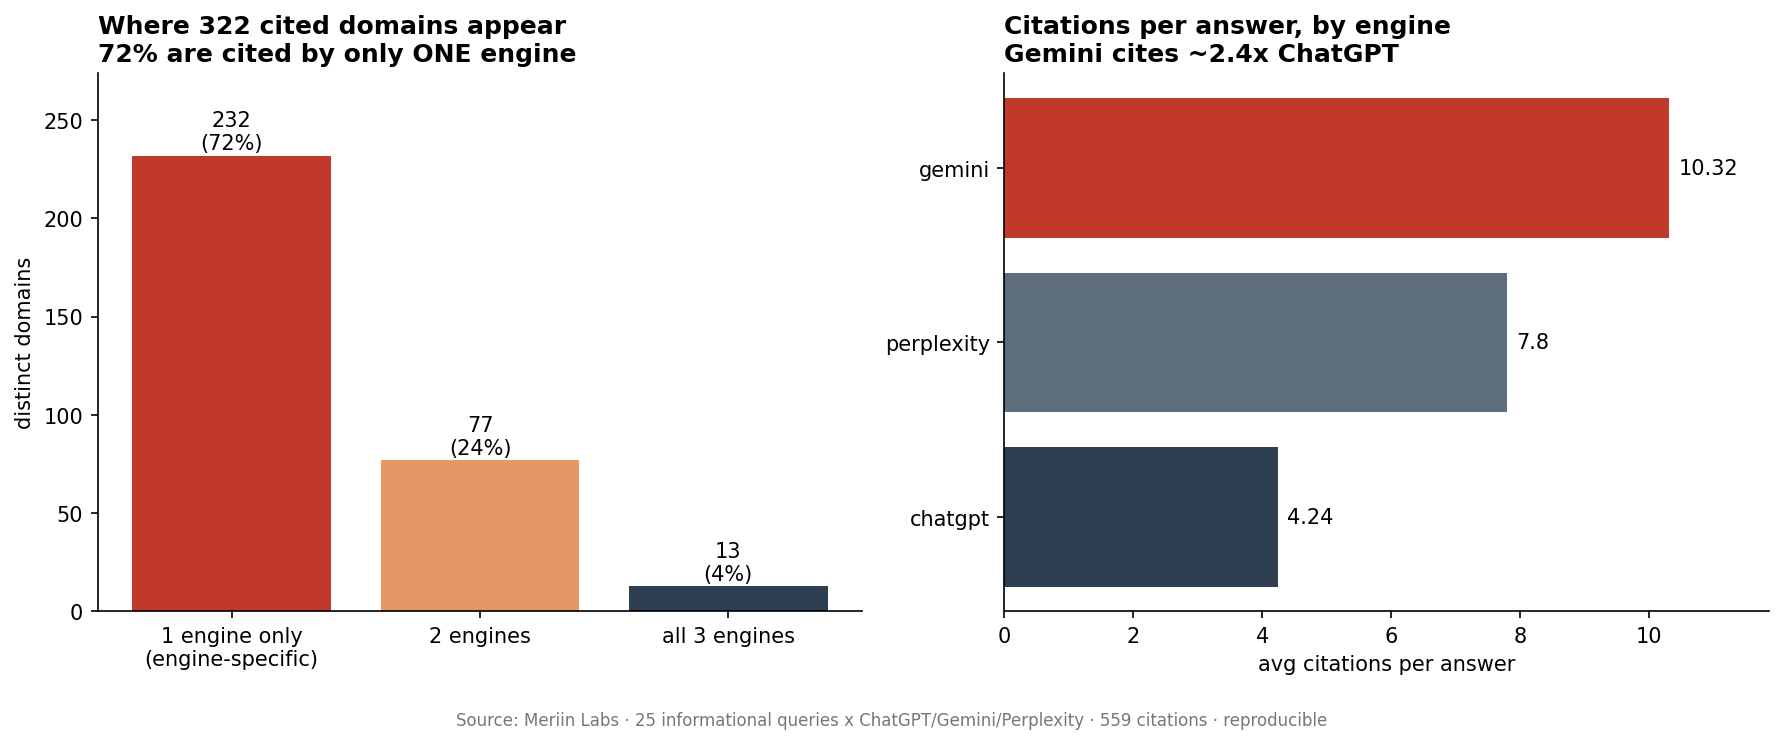
النتيجة 2: حجم الاقتباس يتفاوت 2.4 مرة بين المحركات.
| المحرك | اقتباسات لكل إجابة | نطاقات مختلفة | استعلامات متفرعة (25 سؤالاً) |
|---|---|---|---|
| ChatGPT | 4.24 | 61 | 25 |
| Perplexity | 7.80 | 150 | 0 |
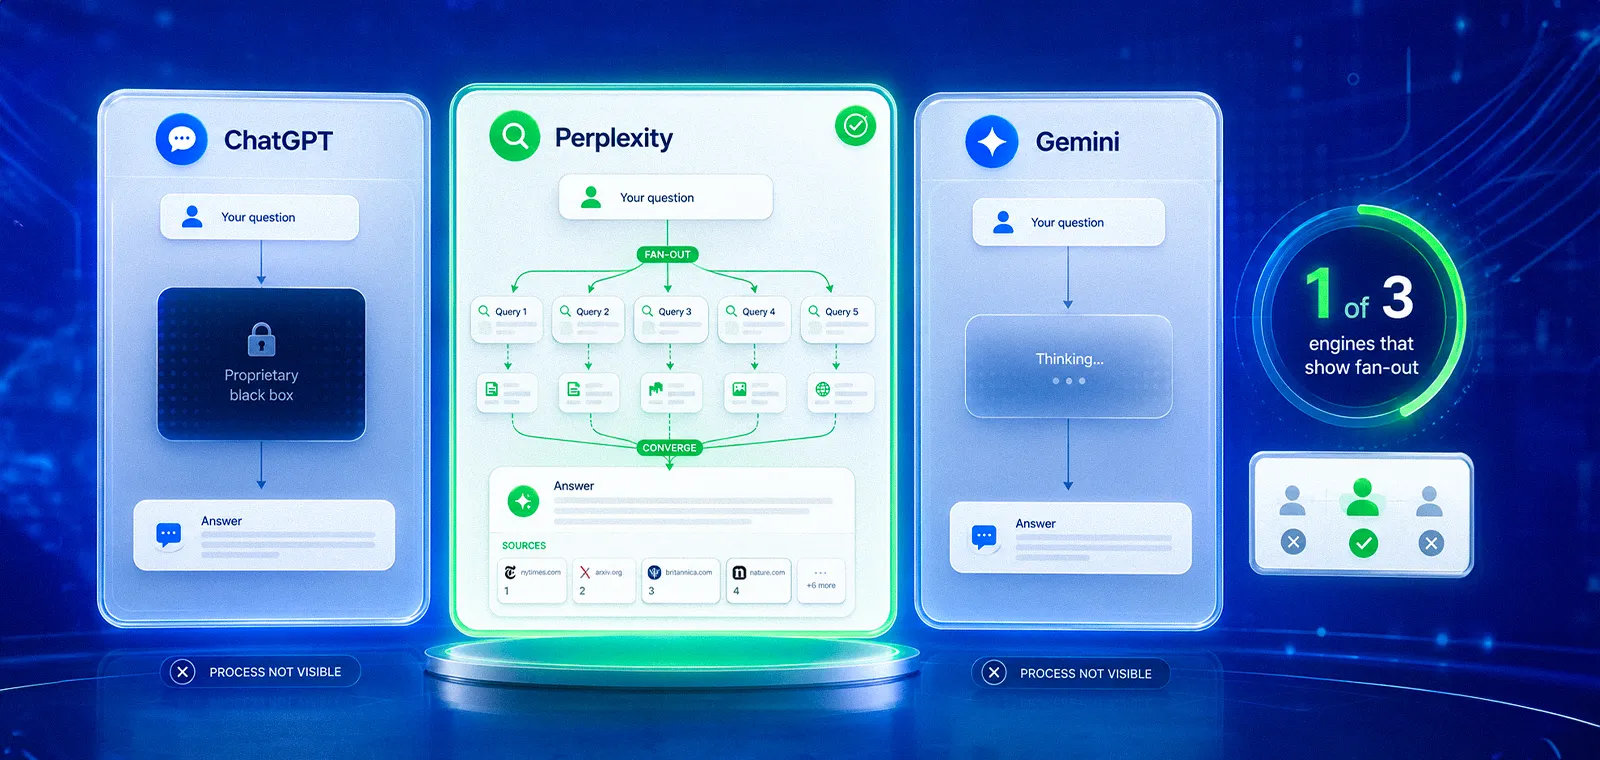
| Gemini | 10.32 | 214 | 69 |
يقتبس Gemini نحو 2.4 ضعف ما يقتبسه ChatGPT من مصادر في كل إجابة، وهو المحرك الوحيد الذي يوسع السؤال فعلاً إلى استعلامات متفرعة (69 استعلاماً فرعياً مقابل 25 عند ChatGPT تكرر السؤال الأصلي). حصتك من اقتباسات أي إجابة تعتمد كثيراً على المحرك الذي تقيسه.
النتيجة 3: الاقتباس التوليدي موزع لا متركز. بلغ مؤشر هيرفندال للاقتباسات 0.0092 (قريب من الصفر)، وحصد النطاق الأكثر اقتباساً (youtube.com) 38 اقتباساً، ولم تتجاوز حصة أعلى 10 نطاقات مجتمعة 19.9% من الاقتباسات كلها. في هذه المحركات الثلاثة، توزعت 559 اقتباساً على 322 نطاقاً. وهذا عكس السوق التي يأخذ فيها الفائز كل شيء.
النتيجة 4: المصادر التجارية تهيمن، والمنتديات والموسوعات هامشية. من أصل 559 اقتباساً، ذهب 434 إلى نطاقات تجارية، والفيديو 38 (معظمه YouTube)، والطبي 31، والتعليمي 29، والحكومي 17، أما المنتديات والمحتوى الذي ينشئه المستخدمون والموسوعات فبالكاد ظهرت بـ6 و4. قصة «الذكاء الاصطناعي يحب Reddit وWikipedia» لم تصمد في ChatGPT وGemini وPerplexity على هذه الأسئلة، وإن اعتمد Gemini على Wikipedia وReddit أكثر بكثير من المحركين الآخرين.
درجة الثقة
- التداخل والحجم والتوزع (المستوى A). حصر كامل للتشغيل محسوب برمجياً. نسبة التداخل 28% وأعداد الاقتباسات لكل محرك ومؤشر التركز دقيقة لهذه البيانات.
- توزيع أنواع المصادر (المستوى B). فئة «تجاري» تجمع كل ما يقع خارج الفئات المسماة، فرقم 78% للتجاري جزء منه أثر لطريقة التصنيف. اقرأه على أنه «معظم المصادر المقتبسة مواقع عادية، لا منتديات أو موسوعات»، لا تصنيفاً دقيقاً.
حدود الدراسة
- حجم تجريبي. 25 سؤالاً بالإنجليزية بنية معلوماتية. يكفي لكسر افتراض المحرك الواحد، ولا يكفي للتعميم على كل قطاع. أداة الدراسة تعمل مع أي مجموعة أسئلة.
- ثلاثة محركات لا كلها. تغطي الدراسة ChatGPT وGemini وPerplexity. ولا تغطي ملخصات Google بالذكاء الاصطناعي (AI Overviews) أو AI Mode، وفيها يتكرر الحديث عن نمط Reddit وWikipedia. وهذا التباين نتيجة بحد ذاته: اختيار المحرك يغير الإجابة.
- على مستوى المصدر لا الجملة. تبين البيانات أي المصادر اقتبست، لا الجملة المقتبسة بالضبط. تحديد الفقرة المقتبسة في كل صفحة مصدر مرحلة لاحقة محددة.
- لقطة واحدة. أنظمة الاسترجاع في المحركات تتغير، وهذه الأرقام مؤرخة، والملحق يتيح لأي أحد إعادة التشغيل.
مقارنة بالأعمال السابقة
الرواية السائدة في GEO، وكثير منها مأخوذ من دراسات ملخصات Google بالذكاء الاصطناعي، تقول إن بحث الذكاء الاصطناعي يتركز في حفنة من نطاقات المنتديات والموسوعات. في ChatGPT وGemini وPerplexity وجدنا العكس: اقتباس موزع (HHI 0.009)، تهيمن عليه المصادر التجارية، باتفاق بين المحركات لا يتجاوز 28%. يمكن أن يصح الأمران معاً، وهذا هو الدرس الحقيقي: «بحث الذكاء الاصطناعي» ليس نظام استرجاع واحداً، والنصيحة التي تعامله كواحد ستصيب في محرك وتخطئ في البقية. الصيغة العملية: اختر المحرك الذي يهم جمهورك وحسن ظهورك لطريقة استرجاعه هو، لا لذكاء اصطناعي عام لا وجود له.
أعد التجربة بنفسك
كل شيء موجود في data/cross-engine-citations/:
collect.py: يسحب بيانات كل محرك عبر DataForSEO LLM Responses API.extract.py: يحلل الاقتباسات، ويتتبع روابط Gemini، ويحسب المقاييس.seed_prompts.json: الأسئلة الخمسة والعشرون.citations.csvوcross_engine.csvوengine_summary.csv: البيانات الكاملة لكل اقتباس ولكل نطاق.FIGURES-LEDGER.csv: كل رقم ورد في هذا المقال.
شغل python3 collect.py ثم python3 extract.py (يحتاج بيانات اعتماد DataForSEO في ملف .env محلي).
الرقم
الأسئلة الخمسة والعشرون نفسها، على ChatGPT وGemini وPerplexity، أنتجت 559 اقتباساً إلى 322 نطاقاً. 28% فقط من هذه النطاقات ذكرها أكثر من محرك، و13 فقط ذكرتها المحركات الثلاثة. واقتبس Gemini 2.4 ضعف ما اقتبسه ChatGPT من مصادر في كل إجابة. لا يوجد «بحث ذكاء اصطناعي» واحد تحسن له.
سجل التحديثات والصلاحية
- صالحة حتى 2026-06-14. تعكس سلوك الاسترجاع في كل محرك في ذلك التاريخ عبر DataForSEO LLM Responses API.
- سنعيد التشغيل على نطاق أوسع ولكل قطاع، والامتداد المخطط مرحلة على مستوى الجملة (تحديد الفقرة المقتبسة في كل مصدر).
- الإصدار 1.0، 14 يونيو 2026: النشر الأول باسم فريق مختبر ميريين. تجربة كاملة (25 سؤالاً × 3 محركات)، وسجل الأرقام مكتوب، وفحص خلو البيانات من معلومات العملاء ومطابقة الأرقام نظيف.
تريد أن تعرف أي محرك يقتبس من فئتك فعلاً، وماذا يقتبس؟ ← احجز تشخيص النمو المجاني
ذات صلة: كل تجارب مختبر ميريين · هل يستطيع نموذج لغوي الحكم على قابلية الجملة للاقتباس؟